无论你是写后端业务、基础架构,还是做测试开发的工程师,只要写过并发测试,几乎都经历过这种让人崩溃的时刻:
线上高并发流量一冲,服务偶发报错甚至崩溃;但你在本地写了个多线程并发测试,开启 50 个线程循环跑了 1000 遍,结果次次全绿通过。好不容易在 CI 流水线上撞见一次红灯,你想挂上调试器(Debugger)或者加两行
这种一观察就消失的偶发并发缺陷,在工程界被称为海森堡缺陷(Heisenbug)。
为什么传统的并发测试抓不到它们?现在开源社区最成熟的 可控调度并发测试(CCT, Controlled Concurrency Testing) 又是怎么做到“几毫秒内精准抓出深层竞态、还能用一串密码 100% 原地复现”的?这篇文章不堆砌枯燥的底层源码,我们用最直观的图解和两个十几行的极简例子,带你一次性看懂开源社区最前沿的可控并发测试技术全景。
核心概念速查表
在开始看图之前,先把几个平时容易混淆的词用大白话对齐:
| 术语 | 大白话解释 | 谁来负责抓它? |
|---|---|---|
| 数据竞争(Data Race) | 两个线程同时读写同一块内存,而且谁都没加锁(俗称“裸奔读写”) | go test -race / 线程消毒器(TSan, ThreadSanitizer) |
| 竞态条件(Race Condition) | 每一步读写虽然都乖乖加了锁,但因为“谁先跑、谁后跑”的执行顺序不对,导致业务逻辑算错了 | 可控调度并发测试(CCT)(本文主角) |
| 线程交错(Interleaving) | 多个线程交替执行时的先后顺序排列(就像两副扑克牌洗牌穿插在一起的顺序) | 调度器(Scheduler)负责接管并编排它 |
| 先查后用漏洞(TOCTOU) | 检查时间到使用时间(Time-of-Check to Time-of-Use):第 1 次加锁看“还有库存”,刚松开锁准备第 2 次加锁扣减时,库存被别人抢光了 | 最典型的跨锁逻辑竞态,-race 完全查不出来 |
| 概率并发测试(PCT) | 微软研究院提出的经典采样算法:Lu 等人(ASPLOS’08)的实证表明绝大多数非死锁并发 Bug 只涉及 ≤2 个线程间的少数先后约束,PCT 只需在随机选中的 个关键时刻强制插队,就能高效命中 | AWS Shuttle / Microsoft Coyote 均内置 |
| 并发气泡(Concurrency Bubble) | Go 1.25 标准库 testing/synctest 提供的确定性时间与协程同步机制:用假时钟和持久阻塞检测消除 time.Sleep 与定时抖动(注:它不探索协程交错,不用于抓跨锁竞态) | Go 1.25+ 官方标准库自带 |
1. 为什么你写的并发测试总是抓不到 Bug?
很多工程师都会困惑:“我已经开了 go test -race,还开了 100 个并发线程狂轰滥炸,为什么线上还是偶发并发故障?”
在解释原因之前,我们先用一张表分清日常测试里最常遇到的 4 种并发 Bug——本文聚焦的不是单一种类,但最容易让传统测试漏网的,是第 2 和第 3 类:
| 并发 Bug 类型 | 大白话现象 | go test -race 能抓吗? | 可控并发测试能抓吗? |
|---|---|---|---|
| ① 数据竞争(Data Race) | 两个线程没加锁同时改同一块内存(裸奔读写),直接破坏内存 | ✅ 专治这个 | 配合使用 |
| ② 死锁(Deadlock) | 线程 A 拿着锁 1 等锁 2,线程 B 拿着锁 2 等锁 1,程序永久卡死 | ❌ 抓不到 | ✅ 轻松抓出 |
| ③ 跨锁逻辑竞态(Race Condition) | 每一步都乖乖加了锁,程序也不会卡死,但因为中间松开过锁被别人插队,导致余额扣成负数 / 缓存读空崩溃 | ❌ 完全抓不到! | ✅ 核心主战场 |
| ④ 异步超时 / 协程抖动(Flaky) | 后台协程还没跑完,主测试就提前断言失败(测试偶发红灯) | ❌ 抓不到 | ✅ Go 1.25 气泡专治 |
下面我们用一个每天都在真实业务里发生的「账户 100 元超扣成 -100 元」案例(属于上面第 ③ 类 逻辑竞态,不是死锁),看看为什么传统并发测试拿它毫无办法:
盲区一:-race 只抓“没加锁”,不管“锁加得不够大”
假设用户账户里只有 100 元,现在用户手抖连点了两次“支付 100 元”(线程 A 和线程 B 同时扣款)。很多同学会疑惑:“谁会蠢到查完余额手动松开锁再去扣钱啊?”
其实写代码的人并不是故意手动松锁,而是调用了两个各自“线程安全”的方法(或临时锁守卫作用域结束自动释放)——这在 Go、Java、Rust 的真实业务代码里都非常容易无意写出来,点击下方标签页按你熟悉的语言切换查看:
仔细看上面这几行代码:它没有死锁(每次只拿同一把锁、方法返回立刻释放,绝不会互相卡死),也没有数据竞争(每一次读余额、改余额都在方法内部乖乖加了锁,go test -race 会毫不犹豫亮起 100% 绿灯)。
那隐患藏在哪? 藏在 GetBalance() 返回松锁、到 Deduct() 重新加锁之间那道极窄的缝隙里——如果线程 A 刚确认“够 100 元”松了锁,线程 B 正好插队进来调 GetBalance() 也看到“够 100 元”并把钱扣成 0 元,紧接着线程 A 回来执行 Deduct(100),账户余额就会被扣成 -100 元(严重超扣资损)!
盲区二:靠操作系统“自由抢麦”,几乎永远撞不中那 10 纳秒缝隙
既然 -race 查不出来,那我在本地起多线程循环跑 1000 遍,总能撞出一次余额变成 -100 元 吧?看下面这张图就知道为什么撞不出来:
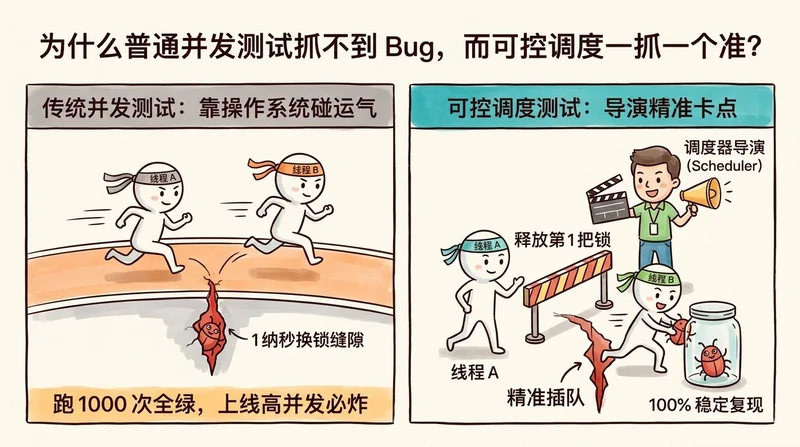
在传统并发测试里,线程调度归操作系统(OS, Operating System)内核管。现代 CPU 跑得极快:线程 A 第 1 次加锁查完余额并松开锁、到第 2 次重新加锁扣钱,中间的危险缝隙可能只有 10 纳秒;单核下操作系统分给线程 A 的时间片长达 几毫秒(数百万纳秒),即便在多核真并行下,两个线程也极难恰好在 10 纳秒的微小窗口里严丝合缝地撞上。
结果就是:绝大多数时候(示意地说 99.999%),线程 A 都会顺滑地完成“查余额 100 元 → 扣成 0 元”;线程 B 姗姗来迟时看到余额已是 0 元,老老实实返回“余额不足”。你在本地跑 1000 遍次次全绿,可一旦上线高并发,偶发卡进那 10 纳秒缝隙就会瞬间超扣资损!
那可控调度并发测试是怎么破局的?它的思路非常霸道:剥夺操作系统的自由调度权,把所有并发线程收编到一个“单线程导演”手里,改成回合制游戏!
点击下方交互动画右上角,亲手切换 「🎲 传统 OS 自由抢麦」 与 「🎬 可控调度回合制导演」,直观感受同一段“100 元扣款代码”为何传统测试跑 1000 次全绿漏检,而可控导演几毫秒就能抓出 -100 元 资损 Bug:
2. 一个 15 行代码的真实翻车现场:大促商品缓存为何偶发 500 报错?
看懂了上面的“账户超扣”直觉,我们再看一个后端服务里几乎每周都会碰到的真实业务故障:热点商品详情本地缓存的“先检查、后取值”。
假设电商商品详情页为了抗流量,把热点商品的价格缓存在内存里,同时有两个并发逻辑在跑:
- 商品查询线程(Worker):用户点进商品详情页,第 1 次加锁看一眼缓存里有没有这个商品;看到有缓存,再第 2 次加锁把商品价格取出来展示给前端。
- 过期清理线程(Evictor):后台定时任务发现这个商品的 5 分钟缓存到期了,加锁把缓存清空。
下面我们用十几行极简代码还原这个线上翻车现场(默认展示 Go 复现传统测试的困境,可切换查看 Java / Lincheck 或 Rust / Shuttle 是如何用可控调度瞬间抓虫的):
如果这是一段普通的多线程测试(比如上面默认的 Go 写法),你在本地跑 1000 次可能都不会崩,因为“检查”和紧接着的“取值”挨得太近了。但交给可控调度器(如 Java 的 Lincheck 或 AWS 开源的 Rust awslabs/shuttle v0.9.10)后,几毫秒内它就能精准抓出空值崩溃,整个犯罪过程被还原得明明白白:
更神奇的是,Shuttle 在报错时不仅告诉你在哪一行崩了,还会在终端吐出一串长度随执行步数变化的十六进制调度串(本例仅 21 字节,格式如下):
1 | failing schedule: |
这串十六进制调度串是什么?它就是这一轮回合制游戏的完整录像带!直接把它贴进 Issue 或缺陷单里,团队里任何人都能原地稳定复现,彻底告别*“我本地跑了 100 遍都没复现,是不是 CI 环境抖动?”*的扯皮。
3. 可控调度的核心魔法:怎么把失控的多线程变成“回合制木偶”?
看到这里,你可能会好奇:测试框架到底是怎么做到让线程“想停就停、想让谁走就让谁走”的?
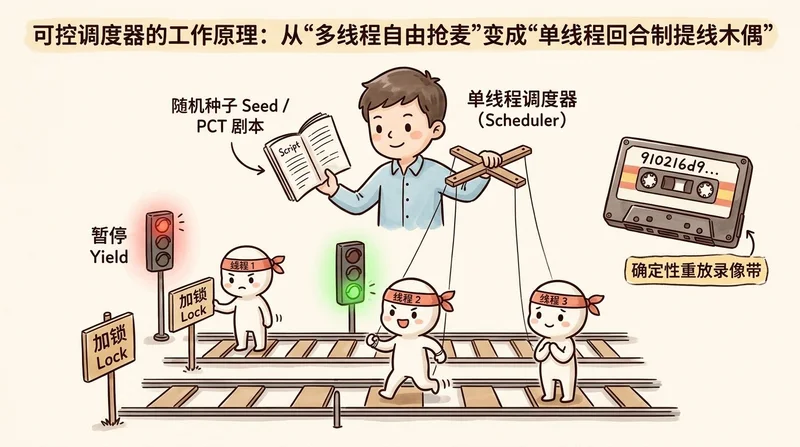
其实不管是什么编程语言的可控并发测试框架,底层的核心魔法都分三步走:
第一步:在所有的“线程交互路口”设卡拦截
想想真实业务代码:如果线程 A 自己在算“满 200 减 30”的折扣金额,线程 B 自己在拼接日志字符串,两边的计算各用各的局部变量,谁先跑谁后跑根本不会出 Bug。只有当它们伸手去碰“大家共用的账户余额锁、热点缓存锁、限流原子计数器、订单消息通道(Channel)或超时定时器”的那一瞬间,先后顺序才会决定生死!
所以,可控并发测试框架只会在这些“共享资源交互路口”设下“安检哨卡”。不同语言的框架,设卡的姿势各有绝活:
- 编译期“换积木”(代表:Rust
Shuttle/Loom): 测试时把标准库的std::sync::Mutex和std::thread换成测试框架提供的同名替身shuttle::sync::Mutex。当你调用.lock()给缓存加锁时,表面上是在加锁,实际上是把控制权交给了背后的单线程导演。 - 字节码“隐形安检门”(代表:Java / Kotlin
Lincheck/ C#Coyote): 连一行业务代码都不用改!利用 JVM 类加载代理(或 .NET IL 二进制重写),在加载或构建你的业务代码时,自动在每个共享字段读写、异步任务和锁指令前塞入暂停钩子。 - 补充路线——语言运行时“透明时间气泡”(代表:Go 1.25
testing/synctest): Go 官方直接在底层运行时(Runtime)里造了一个隔离气泡,天然知道气泡里每一个协程(Goroutine)是在运行,还是在等订单超时定时器、等通道消息。注意区分:synctest提供的是确定性假时钟与持久阻塞同步,它并不会像 Shuttle / Lincheck 那样主动切换并探索协程交错,因此它专治第 ④ 类超时/抖动 Flaky,但抓不到第 ③ 类跨锁竞态。
第二步:回合制串行点名
一旦所有并发线程都被接管,可控调度器在真正跑测试时,同一时刻只放行一个受控线程往前走(例如 Shuttle / Loom 底层跑在单个 OS 线程上切换用户态协程,Lincheck / Coyote 则是挂起其余真实线程、一次只放行一个):
- 第 1 回合:商品查询线程走到
unlock()(刚查完缓存有货、松开第 1 次加锁),主动亮起红灯喊停(Yield),把自己挂起; - 第 2 回合:导演看了一眼“现在谁还能往前走”,翻开剧本点名:“这一步,让过期清理线程上台!” 清理线程立刻加锁把商品缓存清空;
- 第 3 回合:清理线程退场后,导演再把绿灯发回给商品查询线程;查询线程以为刚才查过有数据,第 2 次加锁直接去取价格——当场报错!
因为全程都是导演按顺序串行点名,操作系统内核的随机抖动、CPU 负载高低、甚至你在电脑上同时开着视频会议,对测试交错结果的影响变成了严格的 0%!
第三步:十六进制“录像带调度串”,排查复现再也不扯皮
既然每一步走哪个线程都是导演点名决定的,导演只需要拿个小本本,把 “最开始的随机种子 + 每一步点名轨迹” 按顺序记下来。
一旦 CI 流水线在某一步抓到了崩溃,导演就把这个小本本编码成一串紧凑的十六进制调度串(长度随用例步数变化,像前面这种小用例只需 21 字节,比如 "910216d9d7b69899abb0b31b80405114454a944002")。
为什么平时你在 IDE 里打个红点断点、或者加几行日志,并发 Bug 就幽灵般消失了,而贴上这串录像带调度串后停半小时照样 100% 原地崩溃?点击下方对比交互动画右上角切换两种 Debug 模式,一眼就看穿其中的门道:
这时候,就算你在 IDE 里打上 10 个断点、停下来喝杯咖啡看半小时变量、或者加 50 行调试日志——只要还没增减代码里的锁或同步调用点,重放调度串时线程切换的先后顺序就分毫不差,永远会在同一个地方精准重演崩溃!
4. 调度导演的“排片大脑”:怎么在不跑一亿次的前提下精准抓 Bug?
解决了“怎么控制线程按剧本走”之后,下一个核心难题来了:剧本该怎么写?
算一笔简单的账:哪怕一个下单服务只有 10 个并发线程,每个线程只做 20 次加锁/解锁操作,它们之间所有可能的穿插顺序也是一个超过 的天文数字——把全世界所有服务器凑在一起跑一万年也穷举不完。
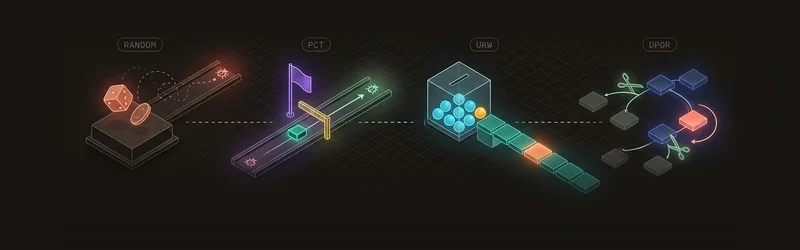
既然穷举不完,导演怎么在短短 100 轮或 1000 轮测试里,正好排出一场能触发 Bug 的剧本?在用 3 个真实后端业务场景逐个拆解之前,先看这张四大调度算法选型速查表,建立全局地图、按业务场景先对号入座:
| 调度算法 | 核心抽签套路 | 最适合测什么业务 | 适用规模与耗时 | 优缺点 / 避坑提醒 | 代表开源工具 |
|---|---|---|---|---|---|
| 盲目抛硬币 (Random) | 每步 1:1 等概率随机抽 | 仅适合极简单的对称小测试,或作为基线对比 | 任意规模,单轮极快 | ❌ 不推荐主力使用;遇到“短任务 vs 长任务”时深层 Bug 漏检率极高 | 各框架基础模式(如 Shuttle RandomScheduler) |
| PCT 随机插队法(主力采样) | 平时按固定优先级顺着跑,只在随机挑出的 个关键点强制插队 | 绝大多数日常并发业务(钱包扣款、热点缓存、异步下单、并发状态机) | 中大型业务(几百~几千行),跑几百轮通常秒级完成 | ✅ 最稳主力首选,对深度 的竞态有严格概率下界;需选好深度参数 (一般 2~3,对应 1~2 次插队) | AWS Shuttle、微软 Coyote |
| URW 剩余步数抽签法(2025 新突破) | 先摸底各线程步数,再按「剩余步数」加权放球抽签,走一步减一球 | 长短流程悬殊的异步业务(1 步查订单 vs 8~25 步后台出库/状态流转/落盘) | 中大型业务,仅多 1 轮热身试跑,整体仍为秒级 | ✅ 专克深层时序 Bug,所有插入空位严格均匀,且无需手调深度参数 | AWS Shuttle(UrwRandomScheduler) |
| DPOR 穷举剪枝法(底层核武器) | 穷举所有交错分支;互不碰同一变量直接剪枝,有共享冲突才强制回溯 | 几十行底层无锁组件(秒杀限流器、自研并发队列、原子内存序验证) | 极小核心代码(< 100 行,2~4 线程) | ✅ 100% 完备不漏测;❌ 严禁直接拿来测大块业务逻辑,会状态爆炸跑不完(注:Lincheck 采用有界切换模型检查,不属于 DPOR) | Tokio Loom |
误区策略 1:每步盲目抛硬币(Random)——为什么测“长流程发货”会彻底失明?
很多工程师第一反应是:“既然每一步导演都要从几个准备好的线程里挑一个,那每一步都像掷骰子一样等概率随机挑一个不就行了?”
听起来很公平,实际上在业务流程长短不一的场景下会彻底失明!想象一个真实的电商订单业务:
- 短任务 A(用户查订单详情,只需 1 步):用户刷新订单页面,读一下订单状态和物流单号,1 步就返回结束了;
- 长任务 B(后台订单出库发货,需要连续走 8 步):依次走完「扣库存 → 算运费 → 核销优惠券 → 开发票 → 通知仓库 → 生成运单 → 第 7 步先提前把状态标成「已发货」,但物流单号要到第 8 步才落盘」;
- 真实线上 Bug:只有当后台发货流程 先走到第 7 步(已标「已发货」但单号还是空),用户恰好在此时刷新查订单(短任务 A),前端就会直接报错 「订单已发货但物流单号为空」!
如果导演每一步都 50:50 抛硬币(一半概率选用户查询,一半概率选后台发货),那么后台发货流程刚走到第 2~3 步,抛硬币就有高达 87.5% 的概率提前把“用户查订单”抽走结束了(此时订单还是“待发货”,查不到任何问题)!想连续 7 次抛硬币都选后台发货、第 8 次再正好选中用户查询,精确概率只有 ;而在真实业务里如果后台出库有 25 步(Bug 在第 24 步),命中概率更是暴跌到 ——普通随机调度跑 10 万次测试几乎不可能抓到这个深层业务 Bug!
主力策略 2:PCT 关键时刻插队法——工业界久经考验的采样武器
为了解决盲目抛硬币的缺陷,微软研究院在 ASPLOS 2010 论文中提出了一个极其聪明的洞见:绝大多数真实的业务并发 Bug,根本不需要几十个线程像麻花一样来回穿插几十次;往往只需要满足 1~2 组关键的先后顺序约束,Bug 就炸出来了!
这个触发 Bug 所需满足的关键先后约束个数,被称为 Bug 深度(Bug Depth, );而 PCT 只需要在随机挑出的 个路口埋下“插队陷阱”(优先级变更点)即可高效命中。比如我们这个「先查后用」的缓存 Bug,需要满足「查询松锁 → 清理清空 → 查询取值」2 个先后约束,深度 ,因此 PCT 只需要随机埋下 个插队陷阱!
我们直接用第 2 节的「热点商品缓存 500 报错」来拆解 概率并发测试(PCT, Probabilistic Concurrency Testing) 到底是怎么干活的:
首先,商品查询线程从头跑到尾一共会经过 3 个路口(同步点):
- 路口 ①(查缓存前):刚进函数,还没开始查缓存;
- 路口 ②(刚查完有货、松开第 1 次加锁后):已经记住“缓存里有货”,但还没发起第 2 次加锁去取价格(这就是致命跨锁缝隙!);
- 路口 ③(第 2 次加锁取完 99 元价格后):价格已经安全拿到手,准备返回给前端。
那么 PCT 的 “排座次 + 埋插队陷阱” 是什么意思呢?分三步看就秒懂:
- 开局先排固定座次:开跑前随机定好优先级排行榜(比如
商品查询线程 (10分) > 过期清理线程 (5分))。平时绝不瞎打断——只要没撞上陷阱,就让排第 1 名的查询线程一口气往前跑(这样长流程任务也能顺畅跑完)。 - 随机挑 1 个路口埋「插队陷阱(Change Point)」:对于深度 的 Bug,导演随机挑 个路口(在 ①、②、③ 里随机选 1 个插上小旗子),规定:“只要第 1 名跑到这面旗子,就强行把第 1 名踢到排行榜队尾,让排第 2 名的「过期清理线程」插队!”
- 跑几十轮,必然踩中致命路口 ②:
- 如果这一轮旗子随机插在 路口 ①(查缓存前):清理线程先清空了缓存,查询线程醒来查到空,安全回源数据库,不会崩;
- 如果这一轮旗子随机插在 路口 ③(取完 99 元价格后):价格都已经安全到手了,清理线程此时再清空缓存,也不会崩;
- 只要有一轮旗子正好随机插在 路口 ②(松锁缝隙):清理线程趁机清空缓存,查询线程醒来直接取价 -> 💥 当场 500 崩溃!
等等:PCT 事先没读过我的业务代码,它怎么知道有哪些路口、总共有几步? 答案非常简单——它根本不需要认识你代码里叫“查缓存”还是“取价格”,全靠第 3 节的哨卡和计数器:
- 谁来报路口? 第 3 节说过,测试框架接管了所有的加锁、解锁、原子变量和 Channel;每次代码执行到这些操作,哨卡就会自动暂停并敲门向导演汇报一次,导演手里的步数计数器顺手
steps += 1(第 1 次回调就是路口 ①,第 2 次回调就是路口 ②……)。- 怎么知道总共会有几个路口? 第 1 轮先摸底跑一遍,数出从头跑到尾一共触发了多少次回调(记作最大步数
max_steps;后续轮次如果走到新分支步数变多,就顺手把max_steps调大)。- 怎么埋陷阱? 下一轮开跑前,导演只需要在
1 ~ max_steps里随机抽 个数字(比如深度 时抽 1 个数字2);跑的时候一数到steps == 2,不管这行代码在干嘛,立刻吹哨把当前第 1 名踢到队尾!
下面这个可交互的 PCT 导演演示器,在画布最上方标出了查询线程的 3 个路口(① 查缓存前 → ② 松锁缝隙 → ③ 取完价格)。你可以点击右上角 3 个按钮,亲自把「🪤 插队陷阱」挪到不同路口,看看为什么只有插在路口 ② 才会撞毁:
靠着“平时一镜到底、只在关键时刻突然插队”,PCT 只需要跑几百轮,就能以严格的数学概率下界把深藏的竞态 Bug 揪出来。AWS Shuttle 和 Microsoft Coyote 都内置了 PCT 作为核心主力采样策略。
前沿策略 3:URW 按剩余步数抽签法(ASPLOS 2025 最新突破)
到了 2025 年,新加坡国立大学(NUS)研究团队(Huan Zhao、Dylan Wolff、Umang Mathur、Abhik Roychoudhury)在 ASPLOS 2025 论文 Selectively Uniform Concurrency Testing 中提出了均匀随机游走(URW, Uniform Random Walk),目前 AWS Shuttle 也已将其合入为 UrwRandomScheduler。
回到刚才那个「1 步用户查订单 vs 8 步后台出库发货」的业务场景,URW 的思路同样非常好懂:为什么之前抛硬币老是把 1 步的“查订单”提前抽走?因为每一步都 1:1 抽签太偏袒短任务了!
- URW 会在第 0 轮先热身跑一遍,摸清每个业务线程大概一共要走多少步;
- 在正式抽签时,把抽签想象成“往抽奖箱里放小球”:后台出库还剩 8 步就放 8 个蓝球,用户查单还剩 1 步就放 1 个橙球(箱子里一共
8 + 1 = 9个球),所以这一步摸中后台出库的概率 = ,摸中用户查单的概率 = ; - 随着后台出库一步步走完,蓝球逐个减少(7 蓝 1 橙 → 6 蓝 1 橙 → …… → 1 蓝 1 橙),把连续护送到第 7 步、再正好抽中用户查单的概率连乘起来,会发生神奇的连锁约分: (1 步查询插在 8 步发货里一共只有 9 个空位,URW 刚好让每个空位被抽中的概率都是严格均等的 ——对比每步抛硬币命中第 7 步的概率 ,命中率直接暴涨 28 倍!)
同理,URW 也是靠「第 0 轮试跑计数」摸清每个线程要走几步的! 只不过 PCT 只需要数一个全局总步数,而 Shuttle 的
UrwRandomScheduler在第 0 轮试跑时会给每个任务签名单独建一本账本(谁敲一次同步哨卡就给谁记+1,连父线程还没spawn出来的子线程步数也会先打包算进父线程,等真正spawn时再划给子线程)。正式开跑时,每走一步就把该线程的剩余步数减 1;哪怕某轮走进了更长的新if分支超出估算,剩余权重也会兜底保持至少为1,绝不会被饿死!
你可以在下面这个互动实验室里,一步步对比 「🎲 盲目抛硬币 (Random)」 和 「⚖️ URW 剩余步数抽签」,再点击 「🔥 点击同时跑 200 轮对比命中次数」,在浏览器里亲眼验证抓出“已发货却空单号 Bug”的真实命中率差距:
微内核策略 4:DPOR 穷举剪枝法(Tokio Loom 专用)
前面三种都是“抽样算法”(适合几千行代码的业务服务,跑几百轮抽样)。那如果你要测的是一个只有 50 行代码的底层无锁组件(比如高并发秒杀网关的限流计数器、或无锁内存队列),想要 100% 穷举所有可能的交错路径,一条都不漏,该用什么?
这就是 tokio-rs/loom(版本 v0.7.3)采用的 动态偏序约简(DPOR, Dynamic Partial-Order Reduction) 算法。它会像走迷宫一样把所有分支穷举一遍,但它有个聪明的偷懒技巧(剪枝):
- 场景 A(零冲突自动剪枝):线程 A 在改用户张三的收货地址,线程 B 在改用户李四的昵称——两边压根不碰同一份数据,谁先跑结果 100% 一模一样,DPOR 直接一剪刀跳过重复路线!
- 场景 B(共享冲突强制回溯):线程 A 在热更新秒杀网关开关(写入
ready = true),线程 B 进来读同一个开关决定是否放行流量——两边碰的是同一个共享变量,DPOR 立刻强制回溯把顺序反过来再跑一遍,确保把“读到旧值false导致误拦截”的边界 Bug 100% 抓出来!
等等:跑之前怎么知道两个线程会不会碰同一块内存?DPOR 真是“先穷举再剪枝”吗? 恰恰相反——这正是 DPOR 里 D(Dynamic,动态) 的精髓!和 PCT / URW 一样,DPOR 的分支点也建在同步原语(原子变量、锁、受控共享对象)上,但它的做法是“先偷懒顺着跑一遍,撞见同地址真冲突再回头补分支”:
- 开局只跑一条默认路线:不提前展开所有分支,先按一个默认顺序(比如先 A 后 B)一口气跑完。
- 每个受控对象自带「访客登记簿」:谁在哪一步读/写了这块地址就记上一笔(如 Loom 里的
last_access)。如果全程像场景 A 那样各自碰不同对象、零交集,整轮跑完直接收工——压根不会生出多余分支!- 撞见真冲突才往回贴「回头再试」便签(Backtrack):只有当两个线程碰了同一个地址、至少一个是写操作(两家纯读不算冲突)、且没有既定的因果先后时,DPOR 才会回到第 1 次访问的那个分支点插上回溯标记,下一轮专门换另一个线程先跑,直到所有便签全部跑完!
点击下方互动动画里的 「✂️ 场景 A(改不同用户资料)」 与 「🔍 场景 B(同碰秒杀开关)」,两步就能看懂 DPOR 裁判是怎么决策的:
一句话记住算法选型:回到本节开头的选型速查表——测日常业务并发或异步服务(下单、支付、缓存),首选基于 PCT / URW 采样的工具(如 Shuttle / Coyote),几百轮就能抓出绝大多数 Bug;只有测几十行底层无锁原子数据结构(限流器、自研并发队列)时,才上 DPOR 穷举(如 Loom)。
5. Go 1.25 标准库大招:testing/synctest 的并发气泡与虚拟时钟
如果你的日常工作主要写 Go 语言,那么好消息来了:从 Go 1.25 开始,官方标准库直接内置了确定性时间与协程同步测试工具 testing/synctest!
先说清楚边界:与前面讲的 Shuttle / Lincheck / Coyote 不同,
testing/synctest不接管 Goroutine 调度顺序,也不探索不同的线程交错(气泡里的协程依然并行运行,因此它抓不到第 ③ 类跨锁逻辑竞态)。它的主战场是第 ④ 类超时、定时器与协程同步引起的慢测试与 Flaky 偶发红灯。
设想一个每个后端工程师都写过、测过的真实业务需求:「电商下单后 10 分钟未支付,后台自动把订单状态改成“已超时取消”」(或者「短信验证码 60 秒后自动失效」)。
以前写 Go 测试测这种超时业务,几乎人人踩过两个大坑:
- 不敢测真实的 10 分钟超时:难道让单元测试干等 10 分钟?于是被迫把超时时间改成
50ms,再在测试里写time.Sleep(80 * time.Millisecond)赌后台协程已经改完状态——结果 CI 机器稍微一卡顿,测试就偶发红灯(Flaky)! - 为了稳妥把
time.Sleep调大到 1 秒:结果整个项目的单测越跑越慢,每次提 PR 都要等半天。
Go 1.25 的 testing/synctest 用一个 并发气泡(Bubble) 彻底终结了这种痛苦。直接看下面这段十几行测“真实 10 分钟未支付自动关单”的代码:
1 | package order_test |
这段代码里,后台协程和主测试协程从虚拟时间 00:00 开始并发等待各自的 time.Sleep(10 * time.Minute)(虚拟时钟一共向前推进 10 分钟),但在你的电脑上跑完整个测试只需毫秒级,而且再也不用靠 time.Sleep 碰运气!跟着下面这个 「订单 10 分钟未支付自动关单」并发气泡互动动画 走一遍,看看 Go 运行时裁判和虚拟时钟是怎么打配合的:
在 synctest.Test 开启的气泡里,Go 运行时当起了全知全能的裁判:
- 什么是持久阻塞(Durably Blocked)? 当气泡里所有协程都停下来,都在等气泡内部创建的通道(Channel)、
sync.Cond、气泡内创建的WaitGroup或time.Sleep定时器时(也就是running == 0),裁判就知道:“如果没有外力推动,大家现在谁也动不了了。”注意:sync.Mutex/RWMutex加锁、网络 I/O 和系统调用都不算持久阻塞——如果有协程卡在Mutex.Lock()上,synctest.Wait()不会返回,假时钟也不会推进。 synctest.Wait()的魔法:以前你不知道后台起的关单协程到底跑到哪一步了,只能盲猜time.Sleep(50ms)。现在调一句synctest.Wait(),主测试协程会一直等到气泡里所有后台协程都跑到持久阻塞点停稳了,才精准恢复往下走断言!- 虚拟时钟(Fake Clock)瞬间快进:当气泡里所有协程都停稳了,而且有人在等 10 分钟后的关单定时器时,裁判不会真去等物理世界的 10 分钟,而是一瞬间把气泡里的假表拨快 10 分钟,立刻唤醒后台关单协程把状态改成
"已超时取消"!
6. 开源社区五大成熟工具全景对比与选型指南
除了上面聊到的 Rust Shuttle 和 Go testing/synctest,在 Java/Kotlin 和 C#/.NET 生态里,也有非常成熟的可控并发测试大杀器。
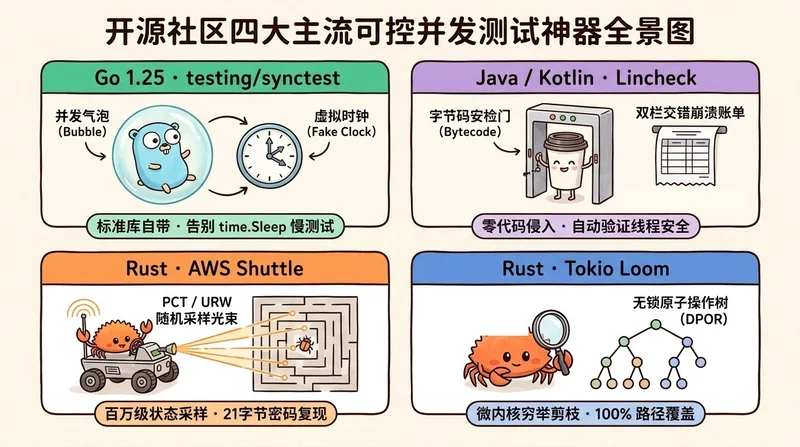
特别是做 Java / Kotlin 后端或 Android 开发与测试的同学,强烈推荐了解 JetBrains 官方出品的 Lincheck。假设你要测一个「外卖骑手抢单队列」(初始队列里只有 1 笔待接单 #1001,两名骑手并发抢这最后一单),Lincheck 有两个极其省心的杀手锏:
- 零业务代码改造 + 自动判断对错:你只需要告诉它“我要测这个并发抢单队列”,它会用字节码插桩自动接管线程调度,并自动对比“多线程并发抢单的结果”是不是和“单线程按顺序抢单的结果”一致(这在学术上叫线性一致性验证,Linearizability Checking),你甚至不用自己写复杂的
assert断言! - 极其直观的“双栏崩溃账单”:一旦抓到并发 Bug(比如两个骑手抢最后一单时,骑手 A 读出
null触发空指针),Lincheck 不会甩给你几千行堆栈,而是直接在控制台画出一张左右分栏的交错反例表(简化示意,模拟 Lincheck 真实输出结构):
1 | = Invalid execution results = |
拿到上面这张图,无论是自己排查还是贴进缺陷单协作,任何人都能在 10 秒钟内看懂:“哦!初始队列里只有 #1001,骑手 A 刚检查完队列 isEmpty() 是 false(还有单!),还没来得及把单子取出来,就被骑手 B 插队把唯一的 #1001 号订单抢走了,导致骑手 A 拿到 null 崩溃!”
下面这张汇总表和交互式选型台,帮你按团队技术栈一键对号入座:
| 工具名称 | 适用语言 | 开源背书 | 核心适用场景 | 代码改造成本 | 报错复现方式 |
|---|---|---|---|---|---|
testing/synctest | Go (1.25+) | Go 官方标准库 | 消除 time.Sleep 慢测试、测试订单超时 / Context 取消与协程同步(不探索交错) | 极低(外包一层 synctest.Test) | 确定性虚拟时钟 + synctest.Wait() |
Lincheck | Java / Kotlin | JetBrains 官方 | 测试抢单队列、本地缓存、锁及 Kotlin 协程的线程安全性(有界模型检查) | 零侵入(JVM 字节码自动插桩) | 自动打印双栏交错崩溃时序表 |
Shuttle | Rust | AWS (S3 ShardStore 团队) | 中大型并发服务、异步 async/await 业务、跨锁竞态(PCT / URW 采样) | 中等(编译开关替换 sync/thread 导入) | 十六进制调度串(如 21 字节)shuttle::replay |
Loom | Rust | Tokio 官方团队 | 几十行代码的底层无锁(Lock-free)限流器、原子队列与内存序验证(DPOR 穷举) | 中等(替换 loom::sync::atomic) | 环境变量保存交错路径检查点 |
Coyote | C# / .NET | 微软研究院(与 PCT 同源) | 异步 Task、微服务订单状态机与 Actor 并发模型测试(内置 PCT 等策略) | 低(自动 IL 二进制重写 coyote rewrite) | 导出 .schedule 轨迹文件在 Visual Studio 单步回放 |
点击下方交互式选型台里的语言方块,直接获取你手头技术栈对应的首选工具、极简上手代码与避坑要点:
7. 工程落地避坑 Checklist
当你准备把可控并发测试引入团队的日常开发与 CI 流水线时,请务必避开以下 4 个最容易踩的坑:
- 测试里千万别混入“不受控的外部时间 / 网络 / 随机源”:
比如在测试订单关单或缓存并发时,如果业务代码里直接去调真实的支付 HTTP 接口、读不受控的系统时钟
SystemTime::now()、或者用了真随机数生成器,会导致每次回放时走上不同分支,重放调度串直接失效。记住铁律:测试边界内的一切外部依赖要 Mock,时间和随机源必须用测试框架提供的受控版本。 - 不要把“可控调度测试”当成“大促性能压测(Benchmark)”: 可控调度为了实现 100% 确定性,同一时刻只放行一个线程按回合制推进。它是用来抓超扣、空指针、死锁等逻辑 Bug 的显微镜,不是用来测系统每秒能抗多少万 QPS 的压测工具。
- 它和
-race(TSan)是黄金搭档,不是替代关系: 回到第 1 节那张分类表:-race专抓“忘了加锁的裸奔内存读写”,而可控并发测试专抓“加了锁但顺序错乱的超扣/空值竞态”和“死锁”,Gosynctest则专治“超时关单等定时/同步 Flaky”。在 CI 里,正确姿势是既开-race跑常规测试,又针对核心并发模块跑可控调度或时间气泡测试。 - 写死循环轮询(比如等支付回调
while !paid {})时要主动让出控制权: 既然同一时刻只有一个受控线程在跑,如果你的代码里写了一个死循环while !paid {}且里面没有任何锁或受控原子操作,当前线程就会一直霸占舞台不下来,另一个负责把paid改成true的回调线程永远上不了台(直接卡死)。遇到轮询等待时,一定要在循环里调用框架的yield_now()或改用受控 Channel / Condvar 等待。
总结
回顾整篇文章,现代并发测试工具其实在做两件非常朴素却极其有效的事情:把过去靠运气碰的“多线程自由赛跑”变成可控调度器编排的回合制棋局(如 Shuttle / Lincheck / Loom / Coyote),以及把依赖物理墙钟的慢测试变成确定性虚拟时钟气泡(如 Go testing/synctest)。
- 如果你使用 Go:升级到 Go 1.25,把测试里依赖
time.Sleep的定时/异步用例换成synctest.Test+synctest.Wait(),同时配合go test -race,可以大幅提速并根治定时与同步类 Flaky; - 如果你使用 Java / Kotlin:给核心并发类加上一个 10 行的
Lincheck测试,让字节码插桩和双栏反例表帮你自动揪出线程安全漏洞; - 如果你使用 Rust / C#:用
Shuttle或Coyote的 PCT / URW 概率调度跑上几百轮,哪怕遇到再诡异的深层竞态,也能凭一串十六进制调度串或轨迹文件在 IDE 里从容地单步复现。

